Qwen zbudował interfejs w 26 minut. Akceptacja zajęła 48
Lokalny Qwen zbudował panel rekrutacyjny od pustego katalogu. Pierwsza wersja wyglądała dobrze, ale miała 251 327 elementów DOM i sześć usterek.
Syntalith
Test zaczęliśmy od pustego katalogu, jednego zdania i lokalnego Qwen3.8-27B sterowanego przez Qwen Code na domowym RTX 3090. Po 26 minutach i 3 sekundach, liczonych od uruchomienia do końca generowania, powstał rozbudowany panel rekrutacyjny z wyszukiwaniem, sortowaniem, etapami procesu, napływającymi zgłoszeniami, szczegółami kandydata i widokiem mobilnym.
Pierwsza wersja nie była gotowa do akceptacji. Detektor pętli zakończył przebieg, zanim agent wykonał pełne testy w przeglądarce. Późniejszy pomiar policzył 251 327 elementów DOM, czyli węzłów dokumentu, a wysokość dokumentu wyniosła 485 065 px. Dwie sesje naprawcze doprowadziły stronę do stanu zaakceptowanego w kontroli. Łączny zarejestrowany czas trzech etapów, liczony od uruchomienia do końca każdego etapu, wyniósł 48 minut i 25 sekund.
Poniżej pokazujemy polecenie, wynik, wykryte usterki i koszt czasowy poprawek. Dane kandydatów są sztuczne. To eksperyment na domowym komputerze, przeprowadzony poza pracą klienta i poza infrastrukturą produkcyjną.
Dokładne polecenie dla agenta
Model działał przez Qwen Code z poziomem rozumowania low i deklarowanym oknem 150 000 tokenów kontekstu. Dostał dokładnie to:
Build me a polished interactive frontend page for an AI recruitment/ATS product from scratch in this empty folder. I want to see what you can do in one shot. Use the Impeccable skill in overdrive mode, but keep it genuinely usable. Surprise me. Make it runnable locally, responsive, and finish and test it without asking me questions.
Nie było makiety, listy komponentów ani gotowego systemu wizualnego. Luźne polecenie miało sprawdzić, ile model zaprojektuje i zbuduje samodzielnie. Jako zlecenie produkcyjne wymagałoby doprecyzowania: nie określało budżetu DOM, wymagań dostępności ani zachowania przy realistycznej liczbie rekordów.
Co powstało po 26 minutach
Qwen stworzył cztery główne pliki tekstowe, łącznie 2028 linii kodu i tekstu oraz 79 588 bajtów:
| Plik | Linie | Zawartość |
|---|---|---|
| PRODUCT.md | 47 | koncepcja produktu i kierunek wizualny |
| index.html | 166 | struktura panelu |
| styles.css | 907 | układ, stany, responsywność i animacje |
| app.js | 908 | dane, filtrowanie, wirtualizacja i interakcje |
Kod generował 10 000 sztucznych rekordów kandydatów. Panel filtrował je według etapu, obsługiwał wyszukiwanie i sortowanie, symulował napływ nowych aplikacji, otwierał szczegóły kandydata i aktualizował liczniki lejka. Zawierał także skróty klawiaturowe oraz obsługę ograniczenia ruchu.
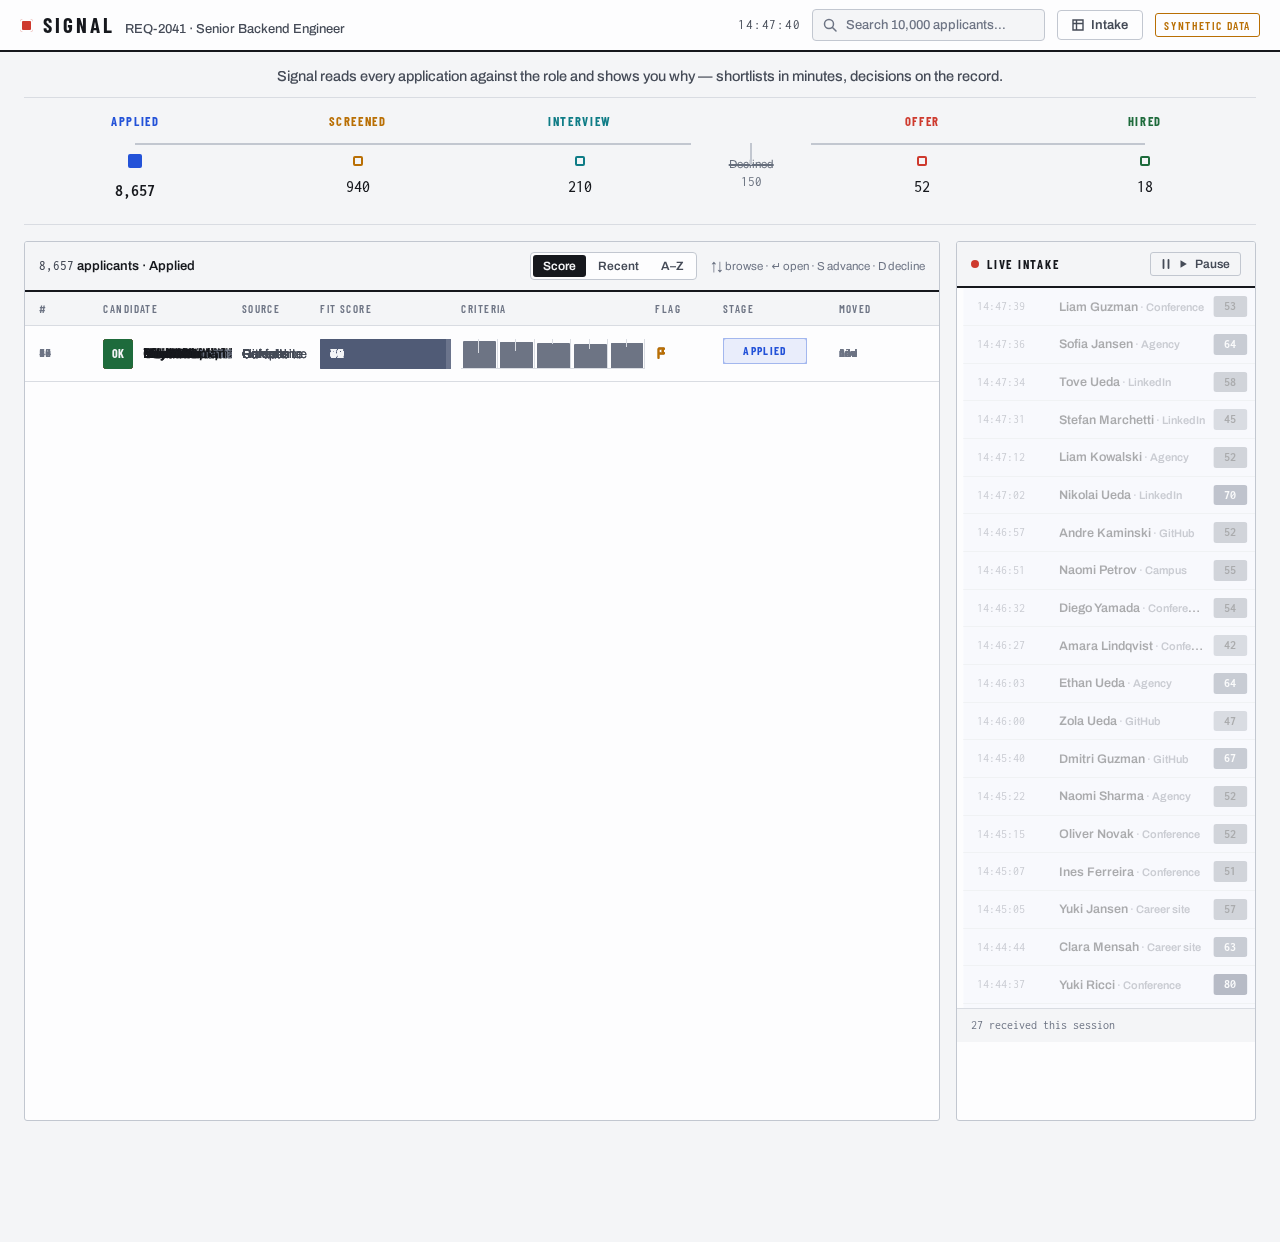
To użyteczna pierwsza wersja z bardzo ogólnego zlecenia. Oceniamy ją przez uzyskany rezultat i czas do akceptacji, bez przekładania tego pojedynczego przebiegu na produktywność człowieka.
Pełna oś czasu
| Etap | Profil | Czas | Wywołania narzędzi | Stan końcowy |
|---|---|---|---|---|
| generacja od zera | Qwen Code low | 26:03 | 55 | interfejs powstał, przebieg przerwany przed testem |
| naprawa i test w przeglądarce | Qwen Code medium | 14:24 | 50 | sześć usterek naprawionych |
| poprawka po obejrzeniu zrzutów | ta sama sesja medium | 7:58 | 20 | dwie poprawki CSS, komputer i telefon zaliczone |
| łącznie | 48:25 | 125 | wynik zaakceptowany po niezależnej kontroli przeglądarkowej |
Tabela nie obejmuje czasu człowieka na przygotowanie polecenia, obejrzenie strony i kontrole wykonane osobno od sesji modelu. Obejmuje trzy zapisane etapy pracy. „Wywołanie narzędzia” oznacza pojedynczą operację odnotowaną przez Qwen Code, na przykład odczyt pliku, komendę lub edycję.
Wcześniejsza wersja tekstu błędnie sugerowała, że naprawa trwała dłużej niż generowanie. Zachowane podsumowania pokazują 22:22 pracy naprawczej wobec 26:03 generowania. Przy planowaniu liczy się 48:25 zarejestrowanego czasu przebiegów do uzyskania zaakceptowanego rezultatu.
Dlaczego wirtualizacja wyrenderowała wszystko
Qwen zaprojektował wirtualną listę, która miała utrzymywać w DOM wyłącznie widoczne rekordy. Pomysł był właściwy, lecz dwa szczegóły implementacji zniweczyły go w przeglądarce:
- obszar przewijania nie miał ograniczonej wysokości, więc jego clientHeight urósł do wysokości całej listy;
- pozycja top trafiała na statyczny element listy, chociaż absolutnie pozycjonowany był wewnętrzny przycisk.
Obliczone okno widocznych rekordów objęło przez to wszystkie 8652 pasujące osoby. Dokument osiągnął wysokość 485 065 px. Zwykły pełnostronicowy zrzut nie kończył się, dopóki przeglądarka testowa tymczasowo nie ograniczyła układu.
Naprawa ujawniła cztery kolejne błędy
Drugie polecenie było konkretne: zachować projekt i interakcje, ograniczyć liczbę elementów, sprawdzić widok desktopowy i mobilny oraz przejrzeć konsolę. Qwen Code z poziomem medium potrzebował 14:24 od uruchomienia do zakończenia tego etapu. Oprócz dwóch usterek wirtualizacji znalazł cztery problemy, których nie było w zgłoszeniu:
| Usterka | Co widział użytkownik |
|---|---|
| brak funkcji setDecisionButtons | otwarcie szuflady kończyło się wyjątkiem |
| użycie STAGES.indexOf(id) na tablicy obiektów | awans kandydata był cichym no-opem |
| ten sam błąd podczas tworzenia historii | starsze etapy znikały z audytu |
| zbyt agresywne pomijanie renderu wiersza | flaga lub etap nie odświeżały widoku |
Po tej sesji osobny przegląd w Chromium zmierzył 722 węzły DOM i 15 widocznych wierszy na desktopie oraz 577 węzłów i 10 wierszy przy szerokości 390 px. Strona mieściła się w obszarze widoku i nie miała poziomego przepełnienia.
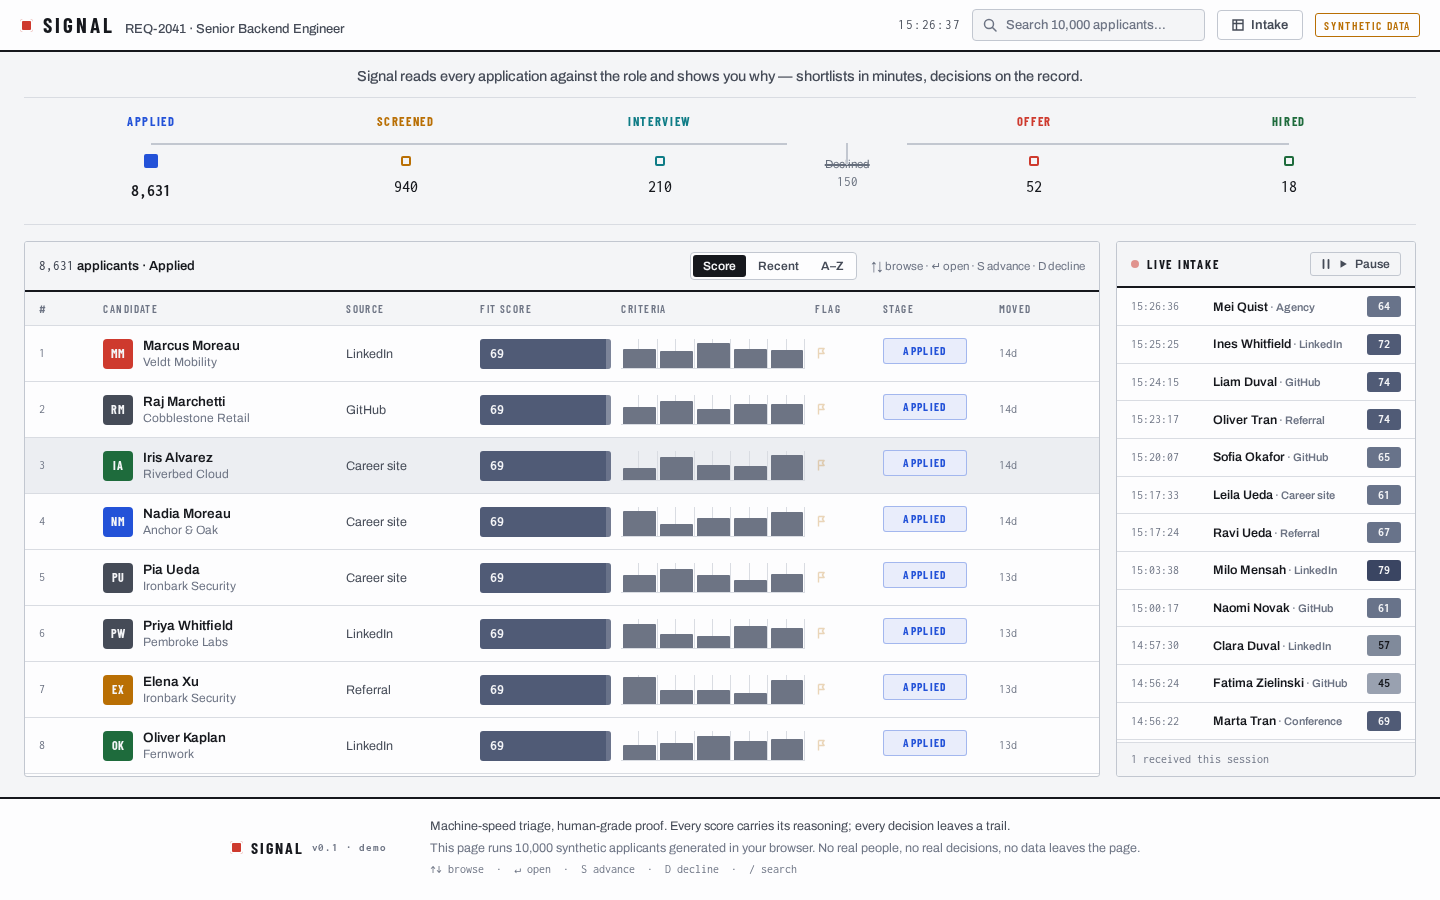
Test geometrii przeszedł, zrzut nadal wyglądał źle
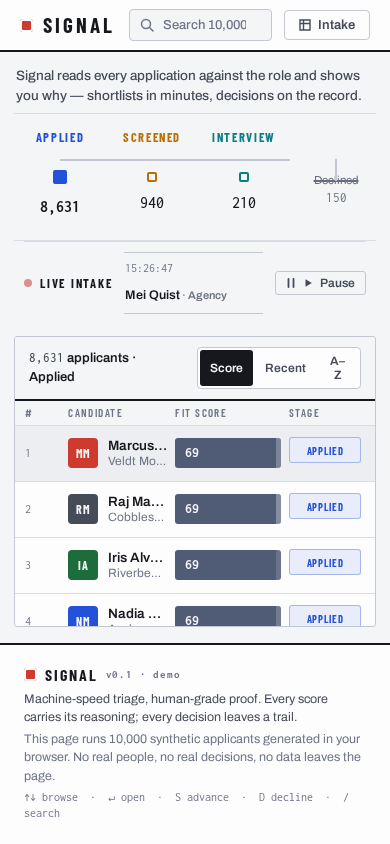
Automatyczna kontrola mierzyła nakładanie prostokątów całych wierszy. Nie porównywała położenia nazwy kandydata i firmy wewnątrz komórki. Na mobile znacznik etapu potrzebował 72–84 px szerokości, a jego kolumna miała 51 px.
Trzecie polecenie opisało oba problemy. Qwen zmienił dwie reguły CSS, lecz wznowienie dużej sesji zajęło 7:58 i 20 wywołań narzędzi. Rezultat był poprawny, choć taki zakres lepiej obsłużyłaby świeża sesja.
Co Qwen faktycznie potrafił
Ten przebieg pokazuje trzy użyteczne możliwości:
- z pustego katalogu stworzył spójny, interaktywny prototyp na podstawie jednego zdania;
- w istniejących 2028 liniach odnalazł zależność między CSS, clientHeight, wirtualizacją i pozycjonowaniem;
- podczas naprawy głównego problemu wykrył cztery niezależne błędy interakcji i danych.
Widać też wyraźną granicę. Wynik po 26 minutach nadawał się do omówienia pomysłu, lecz nie do przekazania użytkownikom. Akceptacja wymagała testu na 10 000 rekordów, pomiarów DOM, sprawdzenia interakcji, kontroli konsoli i obejrzenia zrzutów.
Taki agent jest przydatny, gdy szybko zamienia pomysł w materiał do oceny albo bierze precyzyjnie opisany błąd w odizolowanej kopii. Nadal potrzebuje kryteriów akceptacji i osoby gotowej odrzucić atrakcyjny, lecz wadliwy rezultat.
Masz już prototyp wygenerowany przez agenta?
Syntalith może sprawdzić taki prototyp w podobny sposób: zachować oryginał, wybrać jeden przepływ użytkownika, uruchomić go na realistycznej liczbie rekordów, zmierzyć wydajność i interakcje, a następnie przekazać mapę usterek oraz uzgodniony zakres prac produkcyjnych.
Bezpłatny skan procesu pomaga wybrać przepływ i ryzyko warte sprawdzenia. Audyt procesu AI od 4990 zł netto obejmuje kryteria akceptacji, architekturę, plan i stałą wycenę. Aplikacje AI zaczynają się od 25 000 zł netto.
Pełne pomiary z pozostałych prób są w zestawieniu wyników. Bezpośrednie porównanie klientów opisujemy w artykule Qwen Code, Codex, Claude Code i OpenCode na tym samym Qwenie.
Bezpłatny skan procesów
Zacznij od bezpłatnego skanu procesów.
- 30 minut z inżynierem, który może prowadzić Twoje wdrożenie.
- Przegląd procesów, które kosztują Cię najwięcej czasu i pieniędzy.
- Pisemne podsumowanie: co zautomatyzować, w jakiej kolejności, z widełkami kosztów.
W 30 minut wybieramy proces do oceny, a w ciągu 2 dni roboczych dostajesz rekomendację, także gdy lepsza będzie prostsza droga.
0 zł
30 minut · pisemne podsumowanie w 2 dni robocze
Terminy zobaczysz w swojej strefie czasowej.
Wolisz napisać? Opisz proces