Qwen3.8-27B na RTX 3090: wyniki, metryki i ograniczenia
Zapis jednego domowego eksperymentu z Qwen3.8-27B: profil serwera, czasy, tokeny, energia, VRAM, testy kodu i wykryte błędy wraz z ograniczeniami.
Zmierzyliśmy lokalnego Qwena na zadaniach kodowych i długim kontekście. Wynik obejmuje także błędy, profil serwera i sposób oceny.
Syntalith
Jedna RTX 3090 z 24 GB VRAM wystarczyła, żeby uruchomić Qwen3.8-27B i naprawić dwa miejsca w kodzie Go ignorujące błędy json.Marshal. Qwen Code zachował poprawne odpowiedzi, dodał obsługę błędu serializacji, testy regresji i dokumentację.
Zajęło to 502,14 s, 52 wywołania narzędzi i 28 916 wygenerowanych tokenów. Zużycie energii wyniosło około 33,88 Wh, a szczyt pamięci 22 539 MiB VRAM. Codex ocenił zmianę na 100/100 według arkusza Syntalith. Była to ocena modelu na podstawie testów i kryteriów, bez zewnętrznego audytora.
Dalsze próby ujawniły też brak walidacji w imporcie CSV i poważny błąd wydajności wygenerowanego interfejsu. Artykuł zbiera oba rodzaje wyników z domowego eksperymentu, z jednym aktywnym żądaniem naraz. Dane: zestawienie prób, metryki zadania Go, test kontekstu.
Co to za model i czego dotyczy test
Qwen3.8-27B jest gęstym modelem z około 27 miliardami parametrów części językowej oraz enkoderem obrazu. Oficjalna karta modelu wskazuje licencję Apache 2.0 i natywny kontekst 262 144 tokenów. Przed dystrybucją sprawdź warunki licencji wybranego pakietu wag oraz zależności.
Możliwości opisane przez producenta obejmują tekst, obrazy i wideo. Poniższy eksperyment dotyczy wskazanej konfiguracji lokalnej i zapisanych zadań. Nie potwierdza wszystkich deklaracji producenta ani przepustowości dla wielu użytkowników. Liczba parametrów pomaga oszacować zasoby, ale nie zastępuje oceny jakości na własnym zadaniu.
Profil sprzętowy i serwer
| Element | Użyta konfiguracja |
|---|---|
| GPU | NVIDIA GeForce RTX 3090, 24 GB GDDR6X |
| Model | Qwen3.8-27B, gęsty, natywny kontekst 262 144 tokenów |
| Wagi głównego przebiegu | szybki wariant W4A16 AutoRound |
| Serwer | zamrożony, zewnętrznie zmodyfikowany stos vLLM |
| Klient | Qwen Code 0.21.13, poziom medium |
| Limit kontekstu | 150 000 tokenów |
| Pamięć kontekstu | FP8 KV |
| Dekodowanie | MTP-3 |
| Jednoczesne żądania modelu | 1 |
To opis całego profilu. W eksperymencie zachowaliśmy też llama.cpp z wagami Unsloth Dynamic V3 Q4_K_M GGUF i limitem 120k. Profile różniły się wagami, pamięcią kontekstu, serwerem, dekodowaniem i limitem, więc czasów nie przypisujemy jednemu silnikowi ani samej kwantyzacji.
Długi kontekst
Test umieszczał jeden dokładny fakt na początku, jeden w środku i jeden na końcu syntetycznego rekordu. Model miał zwrócić wszystkie trzy fakty jako JSON. W każdym przebiegu zwrócił 3 z 3 sprawdzanych wartości.
| Profil | Tokeny wejściowe | Przetwarzanie wejścia | Generowanie | Czas całkowity | Szczyt VRAM |
|---|---|---|---|---|---|
| 60k | 50 059 | 890,7 tokena/s | 49,24 tokena/s | 59,3 s | 22 287 MiB |
| 120k | 115 074 | 681,6 tokena/s | 40,46 tokena/s | 172,6 s | 22 649 MiB |
| 250k | 230 085 | 412,4 tokena/s | 28,05 tokena/s | 563,4 s | 23 623 MiB |
Przetwarzanie wejścia to tempo pracy serwera przed generowaniem odpowiedzi. Tempo generowania dotyczy nowych tokenów odpowiedzi. Czas całkowity obejmuje cały przebieg, więc użytkownik odczuwa także wczytanie kontekstu. Test sprawdza odtworzenie trzech wstawionych faktów. Nie mierzy rozumienia całego dokumentu ani powtarzalności wyniku.
Naprawa Go i ocena 100/100
W arkuszu kryteriów znalazły się: poprawność obsługi błędów (40 pkt), testy regresji (20), zgodność dotychczasowego API (15), zakres zmiany (10), weryfikacja testami i kompilacją (10) oraz dokumentacja (5). Dwa zestawy testów uruchomione ponownie, go build ./... i kontrola formatowania przeszły.
100/100 oznacza, że Codex nie odjął punktów względem tych kryteriów w tym przebiegu. Nie jest to prawdopodobieństwo sukcesu i nie opisuje wszystkich projektów Go. Dla porównania, ten sam lokalny model z limitem 120k przez llama.cpp trwał 1468,76 s, zużył szacunkowo 100,36 Wh i otrzymał 98/100. To porównanie całych profili.
Zadania z codziennego użycia
| Zadanie | Klient | Czas | Wynik kontroli |
|---|---|---|---|
| eksport CSV | Qwen Code | 38,24 s | 3/3 publiczne i 3/3 ukryte |
| paginacja | Qwen Code | 264,53 s | 3/3 publiczne i 3/3 ukryte |
| import CSV | Qwen Code | 93,14 s | 12/12 publicznych, 4/5 ukrytych; brak odrzucania pustego imienia i roli |
| import CSV | Codex | 212 s | 11/11 publicznych, 5/5 ukrytych |
| import CSV | OpenCode | 89,04 s | 9/9 publicznych, 5/5 ukrytych |
Testy publiczne są znane agentowi. Ukryte sprawdzają także warunki, których polecenie albo widoczny zestaw nie eksponuje. Wynik importu pokazuje, dlaczego zielony publiczny zestaw nie wystarcza do odbioru procesu.
Porażka i naprawa interfejsu ATS
Jednozdaniowe polecenie z pustego katalogu dało panel ATS w 26 min 3 s. Pierwsza wersja wyglądała ambitnie, lecz wirtualizacja tabeli renderowała 8652 wiersze, 251 327 elementów DOM i dokument o wysokości 485 065 px. Przebieg zakończył się przed pełnym sprawdzeniem przeglądarkowym, ponieważ heurystyka klienta uznała postęp za pętlę.
Naprawa zajęła 14 min 24 s, a wizualna kontrola i kolejne poprawki 7 min 58 s. Niezależna kontrola desktopowa zmierzyła 722 węzły DOM, 15 widocznych wierszy, wysokość 900 px i brak poziomego przepełnienia. Na telefonie było 577 węzłów i 10 wierszy. Przegląd zrzutów znalazł jeszcze kolizję nazwy z firmą oraz obcięty znacznik etapu, więc CSS poprawiono w następnej turze.
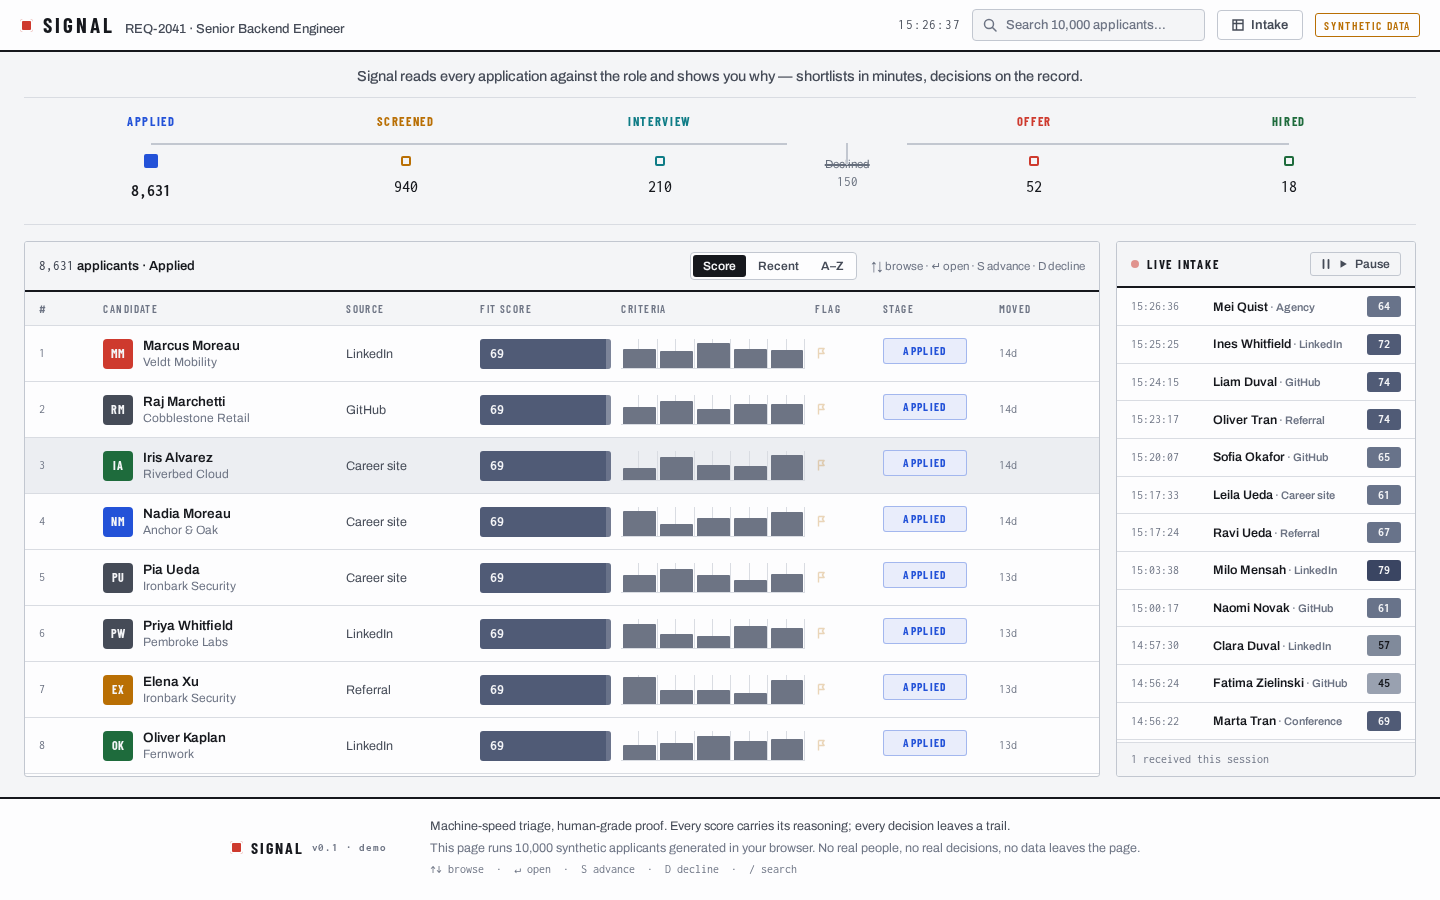
Łączny czas modelu do zaakceptowanego wariantu wyniósł 48:25. Był to syntetyczny interfejs testowy. Nie był produktem klienta.
Ten sam model, różne programy prowadzące
Na tym samym Qwenie uruchomiliśmy Qwen Code, klienta Codex i eksperymentalną ścieżkę Claude Code. Codex jako oceniający przyznał odpowiednio 100/100, 87/100 i 98/100. W każdym przypadku kod generował lokalny Qwen3.8-27B. Zmieniał się klient, sposób pracy z repozytorium i obsługa kontekstu.
Oceniający to program lub model, który po przebiegu stosuje jawne kryteria do wyniku pracy. W tym eksperymencie Codex sprawdzał kod, testy, kompilację, zakres i dokumentację. Wyniki nie są porównaniem Qwena z hostowanymi modelami OpenAI albo Anthropic. Ścieżka Claude Code używała zgodnego interfejsu; Anthropic nie wspiera kierowania Claude Code do modeli innych niż Claude.
Co z tego wynika dla wdrożenia
Jedna RTX 3090 może wystarczyć do pilota, pracy jednego inżyniera albo sekwencyjnej kolejki. Jedno aktywne żądanie modelu nie daje podstaw do obietnicy równoczesnej obsługi wielu osób. Przed wdrożeniem zmierz obciążenie godzin szczytu, długość wejść i odpowiedzi, kolejkę, korekty człowieka oraz zachowanie po restarcie i aktualizacji.
Najbardziej użyteczny zapis testu zawiera polecenie, oczekiwany wynik, ukryte kontrole, wersję modelu, profil serwera i sposób oceny. Dopiero wtedy porównuj lokalny model z mniejszą wersją albo API.
Granice pomiaru
- Każda konfiguracja została uruchomiona raz.
- Test długiego kontekstu sprawdza trzy wstawione fakty.
- Eksperyment obejmował jedną kartę i jedno aktywne żądanie modelu naraz.
- Stos vLLM był zmodyfikowany przez stronę trzecią i zamrożony.
- Oceny 100/100, 98/100 i 87/100 wystawił Codex według arkusza kryteriów Syntalith.
- Porównanie vLLM z
llama.cppobejmowało różne wagi, pamięć kontekstu, silnik i limity.
Dane pozostają dostępne w zestawieniu eksperymentu. Syntalith pomaga wybrać i uruchomić prywatny model na sprzęcie firmy lub osoby prywatnej. Możemy wykonać podobny test na Twoich zadaniach, dobrać hosting albo sprawdzić mniejszy model. Aktualne rodziny opisujemy w przeglądzie Qwen, DeepSeek, Kimi i GLM.

Syntalith ma status OpenAI Select Partner w OpenAI Partner Network.
Pomagamy szybciej odpowiadać klientom i znajdować informacje w firmowych dokumentach. Dobieramy i wdrażamy narzędzia AI, a Twój zespół uczymy z nich korzystać.
Jak wdrożyć ChatGPT i OpenAI w firmieOceńmy prywatne AI w warunkach Twojej firmy
Pomagamy firmom i osobom prywatnym dobrać sprzęt, uruchomić model i sprawdzić go na własnych zadaniach. Możesz zacząć od komputera, który już masz, albo od rozmowy przed zakupem. Pierwsza rozmowa jest bezpłatna, a wycenę przygotowujemy po ocenie zadania i sprzętu.
Prywatne modele LLM i fine-tuning